MasBrowser
客服团队正在加载消息…
正在加载消息…
您正在查看历史会话。
Enter 发送 · Shift + Enter 换行
正在加载消息…
您正在查看历史会话。
Enter 发送 · Shift + Enter 换行
在 2026 年,将干净、结构化的电商产品数据接入你的数据管道,已经是一个有成熟解决方案的问题——前提是你选对了合适的抽象层。大多数团队常犯的错误是:默认选择"自建爬虫",而没有先确认数据是否已经以可用形式存在,或者某个服务商的 API 是否能直接返回带类型的 JSON,省去你这边的解析逻辑。
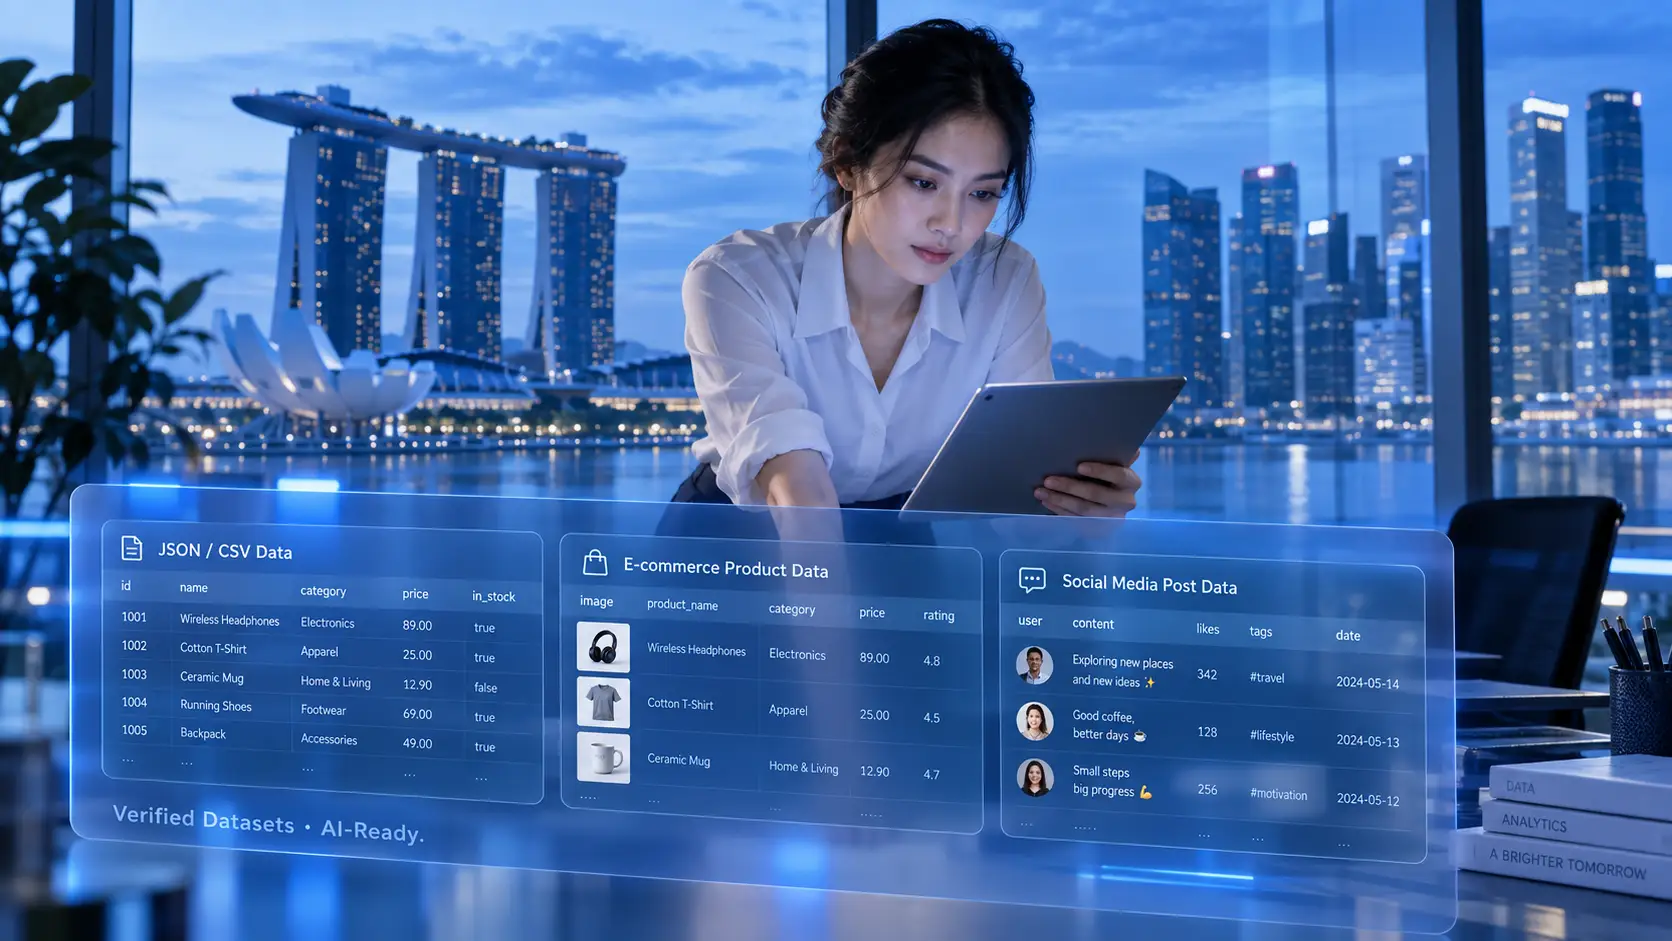
"结构化"的含义远不止"合法的 JSON"。它意味着规范化的字段:product_id(产品ID)、title(标题)、brand(品牌)、variants(变体)、offers(报价,包含价格、货币和库存状态)、images(图片)、category breadcrumbs(分类面包屑),以及 scraped_at(抓取时间戳)。这才是下游 BI 工具和 AI 智能体真正需要的数据形态,与一坨原始 HTML,或是键名杂乱不一致的松散对象,有本质区别。
有两条获取路径可以覆盖 95% 的应用场景:(a) 查询预先采集好的数据集或数据源(data feed);(b) 调用结构化产品数据 API,由服务商在其一侧完成数据提取与类型转换。下面这份清单,会将每种方法对应到最能节省工程时间的具体场景。
如果你的应用场景是可重复的——比如每日价格监控、目录数据补全、竞品对标分析——最快的路径是直接查询服务商已采集好的记录库。无需运行爬虫,无需启动浏览器实例,也无需与反爬机制正面交锋。
Bright Data 的数据集市场(Dataset Marketplace)是这方面最完善的选择。它覆盖数百个电商域名,拥有数十亿条记录,支持以 JSON、CSV 或 Parquet 格式交付,并可通过 API 或 Webhook 灵活配置交付方式。对于需要按固定节奏刷新数据源、而非临时查询的团队来说,这是一条零维护成本的路径。
需要评估的要点: 更新频率(按小时、按天还是按批次)、历史数据可用性、市场/域名覆盖范围,以及服务商是否在交付前对字段做了校验。
当你需要的是某个具体产品 URL、ASIN 或 SKU 的最新数据——而不是昨天的批量数据——结构化产品数据 API 才是正确选择。你只需传入 URL,服务商就会返回一个已完成字段映射的、带类型的 JSON 对象。
Oxylabs 的电商爬虫 API(E-Commerce Scraper API)可以针对主流零售商实现这一点;Zyte 则将其同类产品命名为"电商网页抓取——产品爬虫 API"。两者都用服务商侧的提取逻辑,取代了手写的 CSS 选择器,这意味着当某个零售商重新设计其产品详情页(PDP)时,你的数据管道不会因此崩溃。
签约前需核实: 该 API 是否同时支持列表页和产品详情页?是否能将变体(尺码/颜色/SKU)映射为结构化子对象?在 JS 密集型零售商网站上,官方公布的成功率是多少?
Shopify 店铺及其他 JS 密集型网站,经常会导致基于 DOM 的爬虫失效。Zyte 在其 API 文档中记录的"自动提取"(Automatic extraction)接口,采用 AI 驱动的提取方式来识别页面类型,并返回结构化产品数据,无需固定的选择器映射表。
Bright Data 的爬虫 API 同样在服务商一侧处理 JavaScript 渲染和反爬挑战,因此你无需在自己的基础设施中管理浏览器实例或 IP 轮换逻辑。最终效果是:数据管道故障更少、维护开销更低,当目标网站更新页面布局时迭代速度也更快。
Apify 的电商爬虫分类下列出了大量预构建的"Actor"(可在云端运行的提取脚本),分别针对特定零售商和应用场景。你可以通过 API 调度或触发它们,并获得结构化输出。
当你想要云端执行能力、又不想自己编写抓取逻辑时,这种方式很合适。但风险在于:目录中不同 Actor 的质量参差不齐。在生产环境使用前,务必检查其输出 schema——重点确认产品、价格、库存和变体字段在多次运行中是否保持一致,而不仅仅是在示例输出中"看起来存在"。
Google 官方开发者文档推荐将 JSON-LD 作为最简单的结构化数据格式,许多电商网站会在页面 <head> 中嵌入 Product/Offer/Availability 的 JSON-LD 数据,专门用于搜索引擎索引。这部分嵌入数据同样可以被提取利用。
对于静态页面或服务端渲染的页面,这种方法既可靠又快速。字段可以干净地映射到 Schema.org 类型:name(名称)、sku、offers.price(价格)、offers.priceCurrency(货币)、offers.availability(库存状态)。但需要注意:许多零售商通过客户端 JavaScript 渲染价格,这意味着原始 HTML 中的 JSON-LD 可能显示占位符或过期数值。如果你的目标网站存在这种情况,就需要一个能在提取前先完成 JS 渲染的服务商。
同时需要检查: 目标页面是否包含多变体的报价数组?单 SKU 的 JSON-LD 很常见,但多变体的结构化标记一致性则参差不齐。
Firecrawl 提供了一个免费的产品数据提取器,输入 URL 即可返回结构化 JSON。这对于原型验证提取流程,或在投入生产管道之前先确认某个页面上有哪些可用的结构化字段,是一个很实用的入门工具。
该工具的优势在于上手几乎零门槛。但在规模化场景下的局限也很明显:它并未解决成功率基准测试、主流零售商域名上的反爬可靠性、每千条数据成本建模,以及变体/报价 schema 一致性等问题——而这些恰恰是生产级电商数据管道中至关重要的因素。
如果你本身运营该商店,或与平台有授权合作关系,平台原生 API 会是你能获得的最可靠的结构化数据来源。
Shopify 的 GraphQL Admin API 原生建模了产品与变体,并将库存拆分为 inventoryItems(库存项)和 inventoryLevels(库存水平),包含 available(可用)、committed(已预定)和 on_hand(现有)三种数量状态——这是真实的库存状态,而非面向公众展示的简化片段。亚马逊的产品广告 API(PA-API 5.0)是一个基于 REST 的 API,为经授权的联盟营销人员和出版商提供对亚马逊产品目录的程序化访问。亚马逊的卖家伙伴 API(SP-API)还额外提供了 Feeds API,用于供应商侧的结构化数据操作。
硬性限制在于: 这些 API 都需要身份验证和资质审核。如果你与目标零售商没有合作关系,它们无法帮你监控竞品目录或采集公开定价数据。
抓取与提取的成本并非线性增长。每天批量处理 1 万个产品,与每小时处理 1 万次实时查询相比,即便是同一家服务商,定价也会大不相同。JS 密集型页面通常单次请求成本更高,因为它们需要浏览器渲染。
先梳理清楚你的实际需求:你需要多高的数据新鲜度(按小时、按天,还是按周批量)?每月数据量是多少?重试请求是否会计入配额?服务商的计费方式通常是按请求数、每千条结果,或分层用量套餐。单次请求看起来最便宜的服务商,可能在超量部分有着昂贵的收费政策——这一点在规模化场景下影响巨大。选择能满足你延迟和成功率目标的、最简单的计费模式即可。
即便你从多个服务商拉取数据,或针对不同零售商采用不同方法,你的下游分析工具和 AI 智能体也需要一套统一一致的 schema。请一次性定义好它,并将所有服务商的输出都映射到这套标准之上。
至少应包含的字段:
再加一层校验逻辑:在数据进入下游系统之前,标记出不合理价格(零或负数)、缺失的货币代码,以及空白的库存状态字段。
主流电商网站——亚马逊、沃尔玛、Target,以及大多数大型 Shopify 直营店——都部署了主动的机器人防护、验证码挑战和 JavaScript 门槛内容。如果服务商没有在基础设施层面处理好这些问题,交付的成功率就会参差不齐,进而拖累你整条数据管道的可靠性。
在评估任何服务商时,请明确询问:在主流零售商域名上,官方公布的成功率是多少?重试是如何处理的,是否计入配额?该服务商是默认处理 JS 渲染,还是作为附加功能收费?针对地域限制定价,有哪些区域访问选项?
Bright Data 的基础设施在网络层解决了这一问题——通过住宅、数据中心和 ISP IP 池之间的代理轮换,再配合 Unlocker API 自动处理反爬检测挑战。这正是为什么"99.95% 成功率"这个说法在生产规模下是可信的,而不只是实验室基准测试中的数字。
在注册任何电商产品数据 API 或数据集服务之前,请逐一确认以下问题:
"如何在不自建爬虫的情况下采集结构化电商数据"这个问题的最佳答案,完全取决于你对数据新鲜度的要求和工程能力。零维护、按天批量数据 → 选择数据集或托管数据源;灵活定向的实时查询 → 选择带类型的爬虫 API;大规模场景下追求最高可靠性、且不想管理基础设施 → 选择像 Bright Data 这样的全栈平台,把数据提取、反爬防御和结构化交付整合在同一处解决。